Статьи Nazara
Как найти и исправить ошибку 502 Nginx на VPS
Как найти причину 502 на VPS: проверить журнал Nginx, процесс, порт и upstream, исправить подтверждённый сбой и повторить пользовательский сценарий.
 АвторЮлия Назарова
Ошибка 502 на сайте с Nginx требует проверки приложения, к которому он обращается: работает ли процесс, слушает ли нужный адрес и возвращает ли корректный ответ. Начните с одного неудачного запроса и соответствующей записи журнала. Так Вы сможете найти участок сбоя и восстановить сайт без перезагрузки всех сервисов VPS.
Разбор подходит небольшому веб-приложению, где Nginx принимает HTTPS-запросы и передаёт их backend. Он не предполагает, что любое сообщение Bad Gateway вызвано одной причиной. Команды выполняются на Linux-сервере; example.com, myapp и порт 3000 обозначают учебный пример. Подставьте несекретные параметры своего проекта. Если сервер ведёт администратор, согласуйте изменения с ним.
Что означает 502 и где искать неисправность
502 Bad Gateway означает, что шлюз или прокси получил некорректный ответ от следующего сервера. Код сообщает о месте неудачи в цепочке, но не называет первопричину. Определение приведено в стандарте HTTP. Корректный ответ 500 самого приложения представляет другую диагностическую ситуацию.
Сначала выясните, кто сформировал страницу ошибки. Между браузером и VPS может находиться внешний прокси или балансировщик. Надпись Nginx полезна, однако сама по себе не доказывает, что ответ выдал Ваш сервер. Сопоставьте время запроса с access log, затем найдите сообщение в error log. Если записи нет, проверьте промежуточный сервис и адрес, на который пришёл запрос.
Для статической страницы Nginx обычно читает файл с диска. Для динамического сервиса он соединяется с приложением через TCP-порт или Unix socket. Здесь рассматривается HTTP reverse proxy; PHP-FPM через FastCGI имеет другие директивы и требует отдельного разбора. Не переносите настройки proxy_pass в конфигурацию другой архитектуры.
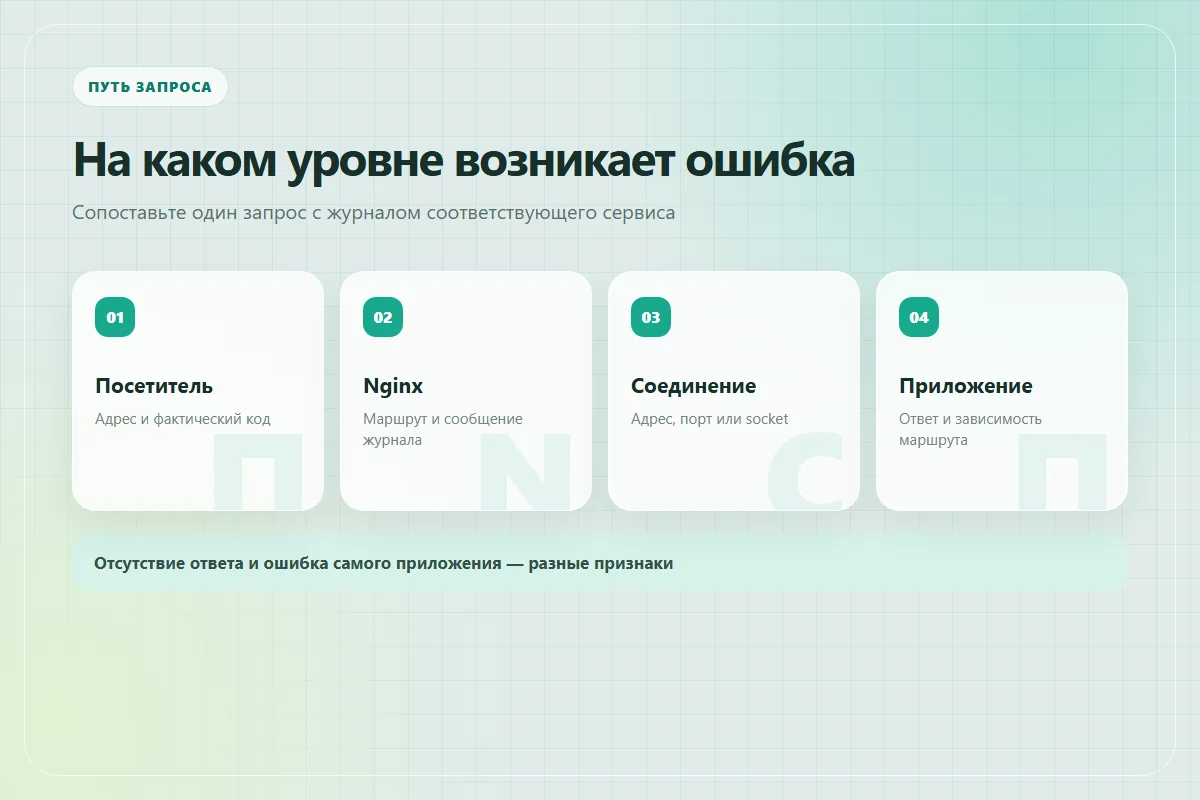
Запишите URL, метод, время с часовым поясом и последнее изменение. Отметьте, ошибка возникает всегда или только при открытии отчёта, загрузке файла, отправке формы. Это определяет проверку после ремонта. Отдельно установите, работают ли остальные страницы. Не подменяйте наблюдение догадкой о перегрузке.
Как собрать данные без изменения сервера
Начните с чтения статуса и короткого фрагмента журнала. Массовые перезапуски могут убрать полезные признаки, прервать соседние проекты и временно скрыть причину. Если неисправность появилась после релиза, сохраните название версии и последовательность её запуска.
curl -I --max-time 10 https://example.com/
sudo systemctl status nginx --no-pager
sudo systemctl status myapp --no-pager
sudo journalctl -u myapp --since "15 minutes ago" --no-pager
sudo tail -n 80 /var/log/nginx/error.log
HEAD-запрос curl -I проверяет заголовки, но приложение может обрабатывать HEAD иначе, чем GET. Для проверки открытия страницы используйте обычный безопасный запрос: curl -sS -o /dev/null -w '%{http_code}\n' --max-time 10 https://example.com/. Не тестируйте операцию, которая списывает деньги, создаёт заказ или отправляет рассылку.
Название службы и путь журнала возьмите из развёртывания проекта. В контейнерной схеме службы myapp может не существовать. Для Docker проверьте список контейнеров и журнал нужного контейнера. docker logs показывает стандартные потоки вывода контейнера, если конфигурация журналирования это позволяет. Отсутствие строки не равно отсутствию ошибки.
systemctl показывает состояние службы, но active не гарантирует исправность каждой функции. В справочнике systemctl описаны команды чтения состояния. Свяжите статус с реальным запросом: если процесс жив, а форма не отправляется, расследование продолжается внутри маршрута и его зависимостей.
Не пересылайте полный журнал в публичный чат. В нём могут находиться персональные данные, адреса закрытых ресурсов и токены. Подготовьте очищенный фрагмент вокруг нужного времени. Сохраните код ошибки и имя компонента, чувствительные значения удалите из копии. Исходные данные оставьте доступными уполномоченному администратору.
Как проверить адрес и порт приложения
Сравните фактический адрес приложения с upstream в конфигурации Nginx. В учебной схеме backend слушает 127.0.0.1:3000, а Nginx запущен на том же VPS вне контейнера. Прямой запрос к этому адресу позволяет отделить backend от публичного прокси.
sudo ss -ltnp
curl -sS -o /dev/null -w '%{http_code}\n' --max-time 10 http://127.0.0.1:3000/
Утилита ss показывает слушающие TCP-сокеты и связанный процесс. Выберите строку своего приложения. Отсутствие порта даёт основание проверить запуск, выбранную переменную PORT и ошибку старта. Наличие порта требует следующего шага: ответа приложения.
Если соединение отклонено, проверьте, завершился ли процесс или сменился адрес. Если запрос возвращает собственный 404, соединение состоялось; возможно, выбран несуществующий путь. Если ответ ожидаемый, исследуйте прокси и различия заголовков. Для маршрутов, зависящих от имени сайта, повторите безопасный запрос с нужным Host. Рабочий health endpoint не подтверждает исправность всех функций.
В контейнере 127.0.0.1 относится к самому контейнеру. Если Nginx и backend находятся в разных контейнерах, localhost не соединяет их. Проверьте имя сервиса, общую сеть и внутренний порт. Если Nginx работает на хосте, ему нужен доступный с хоста адрес. Эти варианты нельзя смешивать в одном тесте.
Не открывайте backend-порт всему интернету ради диагностики. Публичный маршрут может оставаться через Nginx, а внутренний тест выполняться с сервера. Изменение доступа должно быть отдельным решением: иначе маршруты, защищённые только прокси, окажутся доступны напрямую.
Как читать сообщения Nginx
Ищите сообщение для того же запроса и времени. Оно определяет следующую проверку, но не заменяет её. Ниже приведены диагностические направления; фактический код и формулировка зависят от ситуации и конфигурации.
| Признак | Следующая проверка | Опасный поспешный шаг |
|---|---|---|
| Соединение с upstream отклонено | Процесс, адрес, порт и контейнерная сеть | Открыть все порты |
| Upstream закрыл соединение раньше времени | Журнал приложения и аварийное завершение | Считать любой разрыв нехваткой RAM |
| Истекло ожидание ответа upstream | Длительность запроса и его зависимости | Увеличить таймаут без измерений |
| Слишком большой заголовок upstream | Cookies, состав заголовков и буфер | Повысить все буферы наугад |
| Нет доступа к Unix socket | Владелец, группа и права пути | Назначить проекту права 777 |
Таймаут не следует автоматически называть 502: в зависимости от точки сбоя возможен другой ответ, включая 504. Сохраните фактические данные. Медленная страница способна работать без ошибки шлюза, а 502 возникать при мгновенном отказе соединения.
Проверка памяти нужна, если журнал приложения или ядра указывает на завершение процесса либо измерения подтверждают дефицит. Проверка базы нужна, если маршрут обращается к ней. Так Вы сужаете поиск, вместо смены тарифа по одному слову Bad Gateway. Уведомления о доступности описаны в статье про мониторинг VPS.
Сравните успешный и неуспешный запросы. Различие может быть в размере файла, параметрах отчёта или наличии авторизации. Такой тест проводите на обезличенных данных и без повторного выполнения реального заказа. Если ошибка появилась только у одной учётной записи, не выгружайте её данные для общего эксперимента; составьте безопасный воспроизводимый пример.
Что проверить в reverse proxy
Определите server block домена и location проблемного пути. Проверьте адрес proxy_pass, протокол HTTP или HTTPS, преобразование URI и требуемые приложению заголовки. Документация proxy Nginx позволяет сверить конкретную директиву с установленной версией.
Завершающий слеш в proxy_pass способен влиять на передаваемый URI. Если после изменения вложенные маршруты дают 404, сравните ожидаемый backend путь с фактическим. Таймаут такую проблему не исправляет. Для upstream HTTPS важны имя сервера и проверка сертификата; её отключение не должно становиться постоянным ремонтом.
proxy_read_timeout ограничивает ожидание между последовательными чтениями от upstream, а не задаёт универсальную длительность всей операции. Увеличение значения оставляет запросы ожидающими дольше и не ускоряет базу. Для тяжёлой задачи иногда нужен фоновый процесс со статусом; это изменение архитектуры, а не аварийная правка прокси.
Перед редактированием сохраните изменяемый файл и текущую версию приложения. Не публикуйте полный nginx -T: он способен раскрыть внутренние параметры. После минимальной правки выполните sudo nginx -t. Только успешная проверка позволяет переходить к перечитыванию, например sudo systemctl reload nginx, если это штатный способ установки.
Руководство Nginx описывает применение конфигурации. Проверка синтаксиса не отправляет запрос в backend: ошибочный адрес может остаться даже при успешном nginx -t. После перечитывания нужен публичный тест. На общем VPS отдельно проверьте соседний домен, если изменён общий include.
Как восстановить сайт и измерить результат
Выберите действие, подтверждённое данными. Если служба не стартует после релиза, исправьте причину старта или верните совместимую версию. Если ошибочен адрес proxy_pass, измените адрес. Если backend завис на внешнем API, перезапуск может временно вернуть ответы, но условия повторения всё равно нужно устранить.
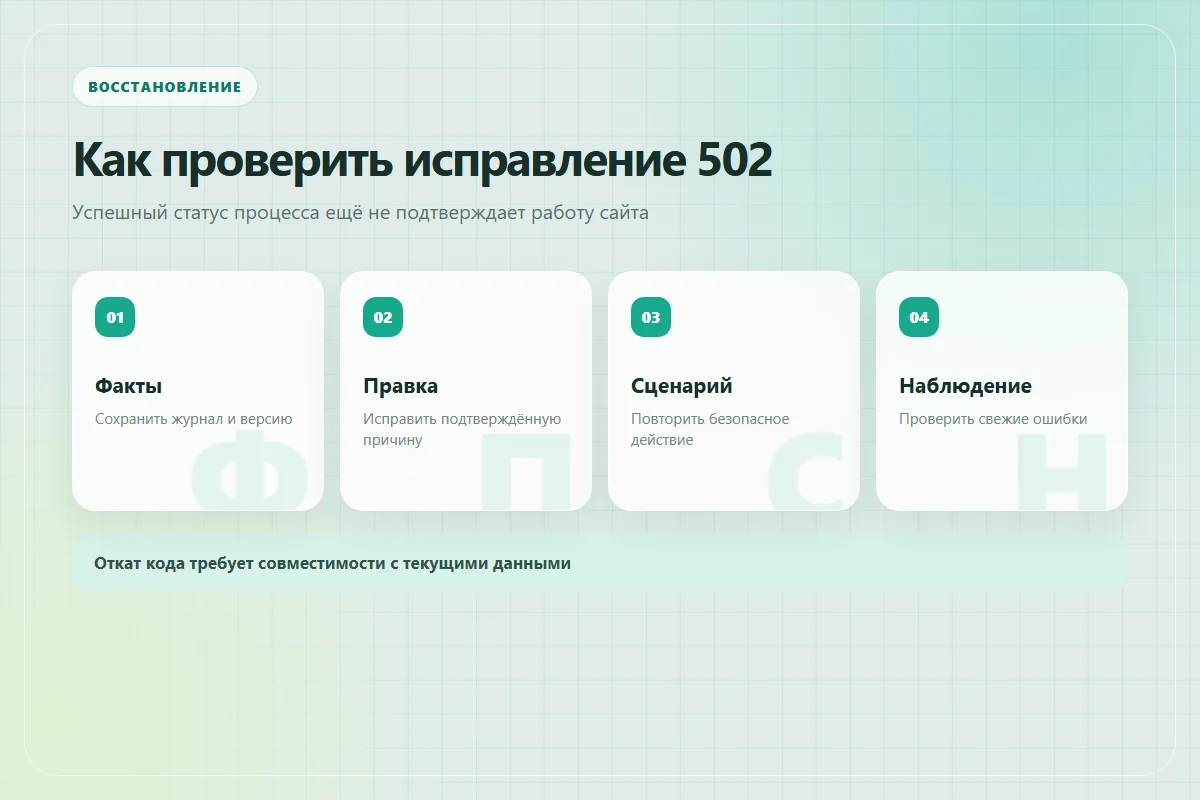
Не откатывайте код вслепую, если релиз менял схему базы или формат файлов. Старый процесс может не понимать новые данные. Нужен согласованный план возврата, а не только архив приложения. Подготовка восстановления разобрана в материале про резервное копирование VPS.
Повторите исходный запрос, затем основной пользовательский сценарий. Для формы это получение тестовой заявки, для отчёта — загрузка небольшого известного набора данных, для кабинета — вход тестовой учётной записью. Выберите операцию без реальных платежей и рассылок. Посмотрите свежий журнал, чтобы не принять старое сообщение за новую неисправность.
Если ошибка непостоянная, одного открытия недостаточно. Понаблюдайте в сопоставимых условиях и запишите проверенный сценарий. Не создавайте нагрузочный тест на production без согласованного ограничения. Формулируйте результат точно: «форма работает после исправления порта», а не «все ошибки навсегда устранены». Сохраните краткое описание причины, чтобы следующий администратор понимал сделанную правку.
Чек-лист диагностики 502
Отмечайте выполненные проверки. Прогресс сохраняется в этом браузере; список не подключается к VPS и не определяет причину автоматически.
Если доступа к VPS нет, передайте администратору очищенные данные: время, URL, воспроизведение, последний релиз и границу сбоя. Чтобы обсудить сопровождение проекта, используйте Умную форму; пароли и токены в обращение не включайте.
Ответы на частые вопросы
Почему главная работает, а форма возвращает 502
Главная может быть статической, а форма обращаться к отдельному backend. Проверьте путь формы и его upstream. Рабочая главная подтверждает доступность только своего маршрута.
Нужно ли переустанавливать Nginx
Сначала найдите границу сбоя по журналу и прямому запросу. Переустановка без установленной причины добавляет изменения и может затронуть другие сайты.
Можно ли проверять приложение через IP сервера
Для части сетевых тестов можно, но запрос по IP способен попасть в другой server block. Сохраняйте правильное имя Host, а для HTTPS учитывайте также имя TLS.
Почему после перезагрузки всё заработало
Перезагрузка могла запустить процесс или освободить ресурс. Без журналов до события это предположения. Проверьте автозапуск и причину завершения, прежде чем считать проблему устранённой.
Поможет ли увеличение памяти
Если измерения подтверждают её нехватку как причину. Ошибочный порт, неверный путь или недоступное внешнее API дополнительная RAM не исправит.
Почему nginx -t успешен, а сайт не работает
Успешный синтаксис не подтверждает доступность upstream и выполнение сценария. Проверьте backend, затем реальный публичный запрос с тем же путём.