Статьи Nazara
Как настроить мониторинг VPS и получать полезные уведомления
Как настроить мониторинг VPS для сайта, бота или приложения: доступность, ресурсы, службы, пороги, уведомления и проверка контролируемым сбоем.
 АвторЮлия Назарова
Мониторинг VPS нужен, чтобы узнать о проблеме раньше пользователя и сразу понять, что проверять. После этой статьи Вы сможете составить минимальный план наблюдения за сайтом, ботом или приложением: выбрать сигналы, определить условия тревоги, настроить уведомления и проверить, что они действительно доходят.
Какую задачу решает мониторинг VPS
Мониторинг отвечает не на вопрос «сколько сейчас процентов процессора», а на вопрос «может ли проект выполнить свою работу и нужно ли человеку вмешаться». Графики помогают разбирать причины и планировать ресурсы. Уведомления нужны для событий, которые требуют действия: сайт перестал отвечать, диск скоро заполнится, служба постоянно перезапускается или резервная копия давно не создавалась.
Начните с перечня последствий. Для сайта это может быть недоступная главная страница, ошибка отправки формы или просроченный сертификат. Для бота — отсутствие ответа на контрольную команду, остановленная очередь или ошибка обращения к базе. Для внутреннего приложения — неработающий вход, сбой фонового задания либо невозможность сохранить запись.
У каждого последствия должен быть владелец и понятное время реакции. Если уведомление приходит человеку, который не может проверить сервер, оно лишь переносит тревогу. Если сообщение не содержит названия проекта и причины, приходится заново искать контекст. Поэтому план мониторинга связывает четыре элемента: сигнал, условие, адресата и первое безопасное действие.
Полезный результат можно сформулировать так: «При сбое критичного сценария ответственный получает проверяемое уведомление, видит затронутый проект и открывает короткую инструкцию диагностики». Эта цель не требует дорогой платформы. Для небольшого VPS достаточно нескольких независимых проверок, если они покрывают реальный путь пользователя.
Какие уровни проекта нужно проверять
Одна проверка не показывает состояние всего проекта. VPS может отвечать на ping, когда Nginx остановлен. Главная страница может открываться, когда форма не записывает заявку. Сервер может быть исправен, а домен — вести на старый адрес. Поэтому контроль удобно разделить на четыре уровня.
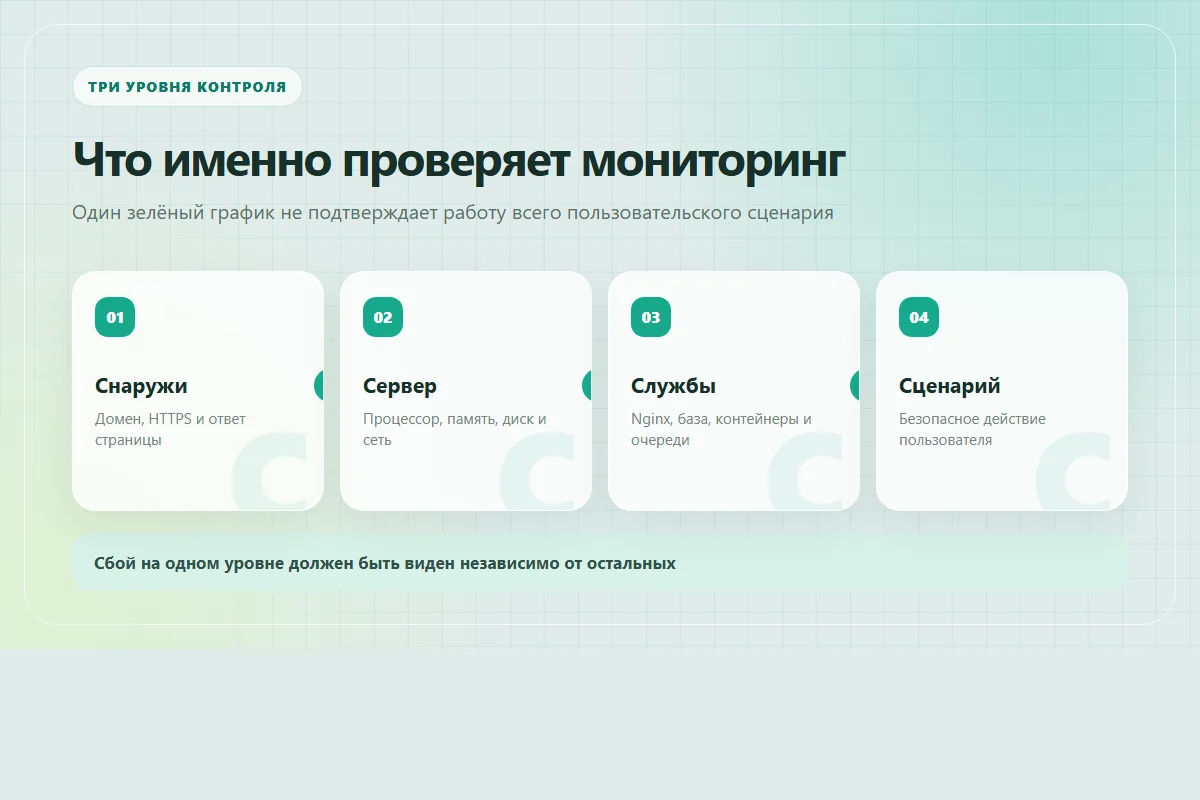
| Уровень | Что проверять | Что обнаруживает |
|---|---|---|
| Снаружи | DNS, HTTPS, код ответа, время загрузки контрольной страницы | Проблемы домена, сертификата, сети и веб-сервера |
| VPS | Процессор, память, диск, inode, сеть, время работы | Исчерпание ресурсов и необычное изменение нагрузки |
| Службы | Nginx, база данных, контейнеры, очереди, задания расписания | Остановку или постоянный перезапуск компонента |
| Сценарий | Безопасное чтение страницы, тестовый запрос или служебная операция | Сбой связи между компонентами при работающем сервере |
Внешнюю проверку запускают не с наблюдаемого VPS, а с другой площадки. Иначе сбой сети или всего сервера выключит одновременно проект и его контролёра. Внутренние метрики, наоборот, собираются рядом с системой: так видны файловые системы, процессы и ресурсы, которые недоступны обычному HTTP-запросу.
Не начинайте с десятков панелей. Для первого этапа достаточно одной проверки на каждом уровне и понятной связи между ними. Когда возникнет реальный вопрос, добавляйте сигнал, который помогает принять решение. Метрика без решения увеличивает объём данных, но не улучшает надёжность.
Какие метрики сервера собирать
Базовый набор описывает ограниченные ресурсы VPS и скорость их изменения. Для Linux обычно наблюдают загрузку процессора, доступную память, использование swap, свободное место и inode на нужных файловых системах, сетевой трафик, ошибки интерфейсов и время работы сервера. Отдельно проверяют состояние критичных процессов и контейнеров.
Процессор оценивайте не по одному мгновенному пику, а по длительности и влиянию на приложение. Короткая загрузка во время сборки или резервного копирования может быть нормальной. Постоянная занятость вместе с ростом очередей и задержки ответа уже указывает на нехватку ресурса или зависшую задачу.
Для памяти важен не только показатель «свободно». Linux использует доступную память для кэша и освобождает её при необходимости. Полезнее наблюдать доступную память, swap, ошибки завершения процессов и тенденцию после запуска приложения. Единичное число без истории часто приводит к ложной тревоге.
Для диска контролируйте и байты, и inode. Свободное место может оставаться, когда исчерпан запас файловых записей из-за множества мелких файлов. Оцените скорость заполнения: уведомление «осталось 15 %» менее полезно, чем понимание, хватит ли пространства до следующего рабочего дня. Отдельно следите за каталогами журналов, загрузками пользователей, базой и резервными копиями.
Один из распространённых способов собрать системные показатели — Node Exporter. В официальном руководстве Prometheus он описан как компонент, публикующий метрики оборудования и ядра, включая доступное место файловой системы, процессорное время и сетевой трафик. Это пример инструмента, а не обязательный выбор: те же вопросы можно закрыть управляемым сервисом или другим агентом.
Как проверять доступность и пользовательский сценарий
Проверка HTTP должна обращаться к тому же публичному адресу, которым пользуется человек. Контролируйте разрешение домена, установление TLS-соединения, ожидаемый код ответа и ограничение по времени. Если приложение корректно отвечает перенаправлением, не требуйте от него только код 200: задайте ожидаемое поведение конкретного URL.
Проверка главной страницы подтверждает лишь выдачу страницы. Она не доказывает, что база принимает запросы, фоновая очередь работает, а форма отправляет заявку. Для критичного проекта добавьте небольшой безопасный сценарий: открыть служебный endpoint, прочитать тестовую запись или выполнить операцию в изолированной тестовой учётной записи.
Сценарий не должен создавать реальные заказы, отправлять письма клиентам или загрязнять рабочую базу. Если без записи проверить нельзя, используйте специальную тестовую сущность и удаляйте её предсказуемым способом. Зафиксируйте ожидаемый результат и максимальное время ответа.
Blackbox Exporter из официального проекта Prometheus умеет выполнять внешние проверки по HTTP, HTTPS, DNS, TCP, ICMP и gRPC; метрика probe_success показывает успех пробы. Описание возможностей и ограничений находится в репозитории blackbox_exporter. Для небольшого сайта можно использовать и более простой внешний сервис доступности — принцип остаётся тем же.
Добавьте контроль срока TLS-сертификата заранее, а не в день окончания. Конкретный запас зависит от способа продления и времени реакции. После настройки автоматического продления однажды проверьте весь цикл: сертификат обновился, веб-сервер перечитал его, а внешняя проверка видит новую дату.
Как назначать пороги без лишних тревог
Универсальных порогов для любого VPS нет. Значение зависит от размера сервера, характера нагрузки, времени суток и последствий. Порог 80 % по процессору ничего не говорит без длительности: краткий пик допустим, постоянная загрузка может замедлить запросы и фоновые задания.
Сначала соберите нормальную историю за несколько рабочих циклов. Отметьте резервное копирование, импорт данных, рассылки и другие ожидаемые пики. Затем назначьте предупреждение раньше критического состояния и отдельную тревогу, когда действие уже необходимо. Для диска это могут быть разные уровни, но конкретные проценты выбирают по скорости роста и времени реакции, а не копируют из чужой инструкции.
Используйте условие длительности. Если показатель вышел за границу на несколько секунд и вернулся, будить человека обычно не нужно. Prometheus позволяет добавить к правилу секцию for: тревога переходит в состояние firing, только когда выражение остаётся истинным заданное время. Механика описана в официальной документации alerting rules.
Разделите симптомы и причины. Недоступная страница — важный симптом, высокая загрузка процессора — возможная причина. Если уведомлять только о ресурсах, можно пропустить ошибку приложения при свободном сервере. Если уведомлять только о странице, диагностика займёт больше времени. Связанные сигналы показывайте рядом, но не превращайте один сбой в десять одинаковых сообщений.
У каждого правила должен быть тест. Временно уменьшите порог в безопасной среде, остановите тестовую службу или направьте проверку на контролируемый неверный адрес. Затем верните конфигурацию и убедитесь, что пришло и сообщение о восстановлении. Непроверенное уведомление остаётся предположением.
Что должно быть в полезном уведомлении
Хорошее уведомление можно понять без входа на сервер. Оно содержит название проекта и среды, время начала, сработавшее условие, текущее значение, ссылку на соответствующий график или журнал и первый безопасный шаг. Сообщение «CPU high» без адреса VPS и длительности заставляет заново проводить всю диагностику.
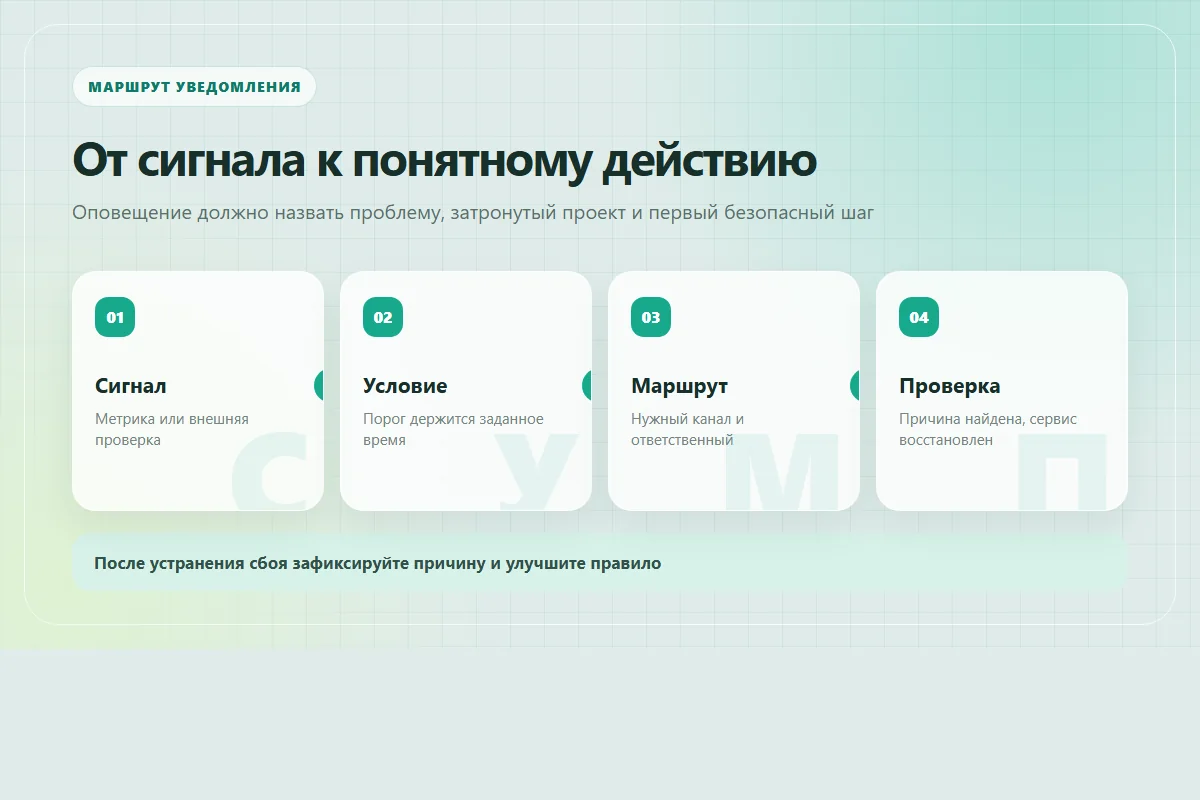
Назначьте уровни важности. Критичное событие означает, что пользовательский сценарий уже не работает или данные находятся под угрозой; оно требует быстрой реакции. Предупреждение показывает тенденцию, с которой можно разобраться в рабочее время. Информационное событие остаётся в журнале и не обязано отправляться в личный канал.
Маршрут зависит от времени и владельца. У небольшого проекта это может быть один Telegram-чат и резервный способ связи. У команды — дежурство и распределение по сервисам. Проверьте, что сообщения от мониторинга нельзя случайно заглушить вместе с обычными уведомлениями приложения.
Alertmanager принимает тревоги от Prometheus, группирует их, подавляет зависимые сообщения, поддерживает временное отключение и отправляет уведомления в выбранные каналы. Такое разделение описано в официальном обзоре Prometheus. Даже при другом инструменте полезно сохранить тот же принцип: обнаружение, группировка, маршрут и доставка — разные этапы.
Контролируйте сам канал мониторинга. Если агент перестал отправлять данные, это не «ноль ошибок», а отсутствие наблюдения. Создайте сигнал о пропавшей метрике и периодический тест доставки. Ответственный должен знать, когда последнее контрольное уведомление успешно прошло весь маршрут.
Как хранить журналы и не открыть мониторинг интернету
Журнал помогает ответить, что происходило перед сбоем, но не заменяет метрики. Собирайте ошибки приложения, перезапуски служб, результаты заданий расписания и значимые события доступа. Настройте ротацию, чтобы журналы сами не заполнили диск. Срок хранения выбирайте по задачам расследования и требованиям к данным.
Не записывайте в журнал пароли, токены, полные платёжные данные и содержимое приватных запросов. Ошибка приложения может вывести секрет вместе с трассировкой. Проверьте маскирование чувствительных полей и права на чтение журналов до подключения централизованного сбора.
Интерфейсы метрик и панели не должны автоматически становиться публичными. В модели безопасности Prometheus отдельно указано, что endpoints компонентов, включая /metrics, не следует открывать общедоступному интернету без осознанных защитных мер. Полное предупреждение приведено в официальной документации по безопасности Prometheus.
Ограничьте доступ firewall, приватной сетью или reverse proxy с аутентификацией и TLS. Выдавайте права только тем, кому нужны метрики и правила. Дашборд может раскрывать имена внутренних сервисов, адреса, версии и характер нагрузки — это рабочая информация, а не публичная витрина.
Мониторинг и наблюдаемый проект по возможности разделяют. Если панель, хранилище метрик и уведомления находятся на том же VPS, его полная недоступность лишит одновременно сервиса и диагностики. Минимум одна внешняя проверка и канал доставки должны продолжать работать независимо.
Как внедрить минимальный мониторинг по шагам
Начните с небольшой карточки проекта. Укажите публичный адрес, критичный сценарий, список служб, каталоги с растущими данными, владельца и допустимое время реакции. Рядом запишите, где открывать журнал и как безопасно перезапустить конкретный компонент.
- Добавьте внешнюю проверку. Контролируйте домен, HTTPS, ожидаемый код и время ответа с другой площадки.
- Соберите ресурсы VPS. Наблюдайте процессор, доступную память, swap, место, inode и сеть.
- Проверьте службы. Отслеживайте Nginx, базу, контейнеры, очереди и обязательные фоновые задания.
- Опишите один сценарий. Выберите безопасное действие, которое подтверждает связь компонентов.
- Настройте два уровня правил. Предупреждение для тенденции и критичную тревогу для реального нарушения.
- Соберите понятное сообщение. Проект, условие, длительность, график и первый шаг.
- Проверьте доставку. Создайте контролируемый сбой и дождитесь уведомления о проблеме и восстановлении.
- Пересмотрите через месяц. Удалите шумные правила, уточните пороги и добавьте только недостающие сигналы.
После инцидента сохраните короткую запись: что увидел пользователь, какой сигнал сработал первым, сколько заняло восстановление и чего не хватило. Это превращает реальный сбой в улучшение мониторинга. Не меняйте порог только ради тишины — сначала установите причину ложного или частого срабатывания.
Перед мониторингом сервер нужно безопасно подготовить: используйте чек-лист настройки VPS после покупки. Для защиты данных пригодится статья о резервном копировании и проверке восстановления. Если ресурсов постоянно не хватает, вернитесь к критериям из материала как выбрать VPS для проекта. Все материалы направления находятся в разделе «Серверы и инфраструктура».
Частые вопросы
Достаточно ли проверять только доступность сайта?
Нет. Страница может открываться при неработающей форме, базе или фоновой задаче. Сочетайте внешнюю проверку с ресурсами VPS, состоянием служб и одним безопасным пользовательским сценарием.
Какие метрики VPS нужны в первую очередь?
Начните с процессора, доступной памяти, swap, свободного места, inode, сети и состояния критичных служб. Затем добавляйте показатели приложения, которые помогают обнаружить конкретный сбой или принять решение.
Как часто запускать проверки?
Интервал зависит от допустимого времени простоя и стоимости проверки. Критичный внешний endpoint проверяют чаще, тяжёлый пользовательский сценарий — реже. Условие тревоги должно учитывать несколько последовательных результатов, чтобы единичный сетевой сбой не создавал шум.
Нужно ли устанавливать Prometheus на маленький VPS?
Не обязательно. Prometheus удобен для истории метрик и гибких правил, но небольшой проект может начать с внешнего сервиса доступности и лёгкого агента. Выбирайте минимальное решение, которое покрывает критичные сценарии и проверяемую доставку уведомлений.
Куда отправлять уведомления о сбоях?
В канал, который ответственный действительно заметит и не выключит вместе с обычными сообщениями. Для критичных событий предусмотрите резервный маршрут. В уведомлении укажите проект, условие, время и первый шаг диагностики.
Как понять, что мониторинг работает?
Создайте контролируемый сбой, дождитесь тревоги, восстановите сервис и проверьте сообщение о нормализации. Отдельно контролируйте свежесть самих метрик и периодически тестируйте доставку в каждый рабочий канал.